Rapide, mais jamais faux
Un cache de réponses à quatre niveaux — exact, canonique, quasi-doublon et sémantique — avec des garde-fous qui rejettent une correspondance quand les nombres, la négation ou les noms diffèrent. Absorbez le bruit ; ne servez pas la réponse à une autre question.
"Absorbez le bruit (espaces, virgules, un point d'interrogation en trop) sans servir de mauvaises réponses quand le sens change."
L1 · Exact
Un SHA-256 sur la requête brute — modèle, messages, paramètres et outils. Les appels identiques répondent instantanément, sans aucune correspondance approximative.
L1b · Canonique
Réduit les suites d'espaces et supprime ceux des extrémités, rien d'autre. Ni passage en minuscules ni suppression de la ponctuation, car cela peut changer le sens.
L2 · Quasi-doublon
Un SimHash 64 bits repère les requêtes qui ne diffèrent que cosmétiquement — un point d'interrogation final, une virgule en trop — et chaque candidat doit encore passer les garde-fous.
L3 · Sémantique
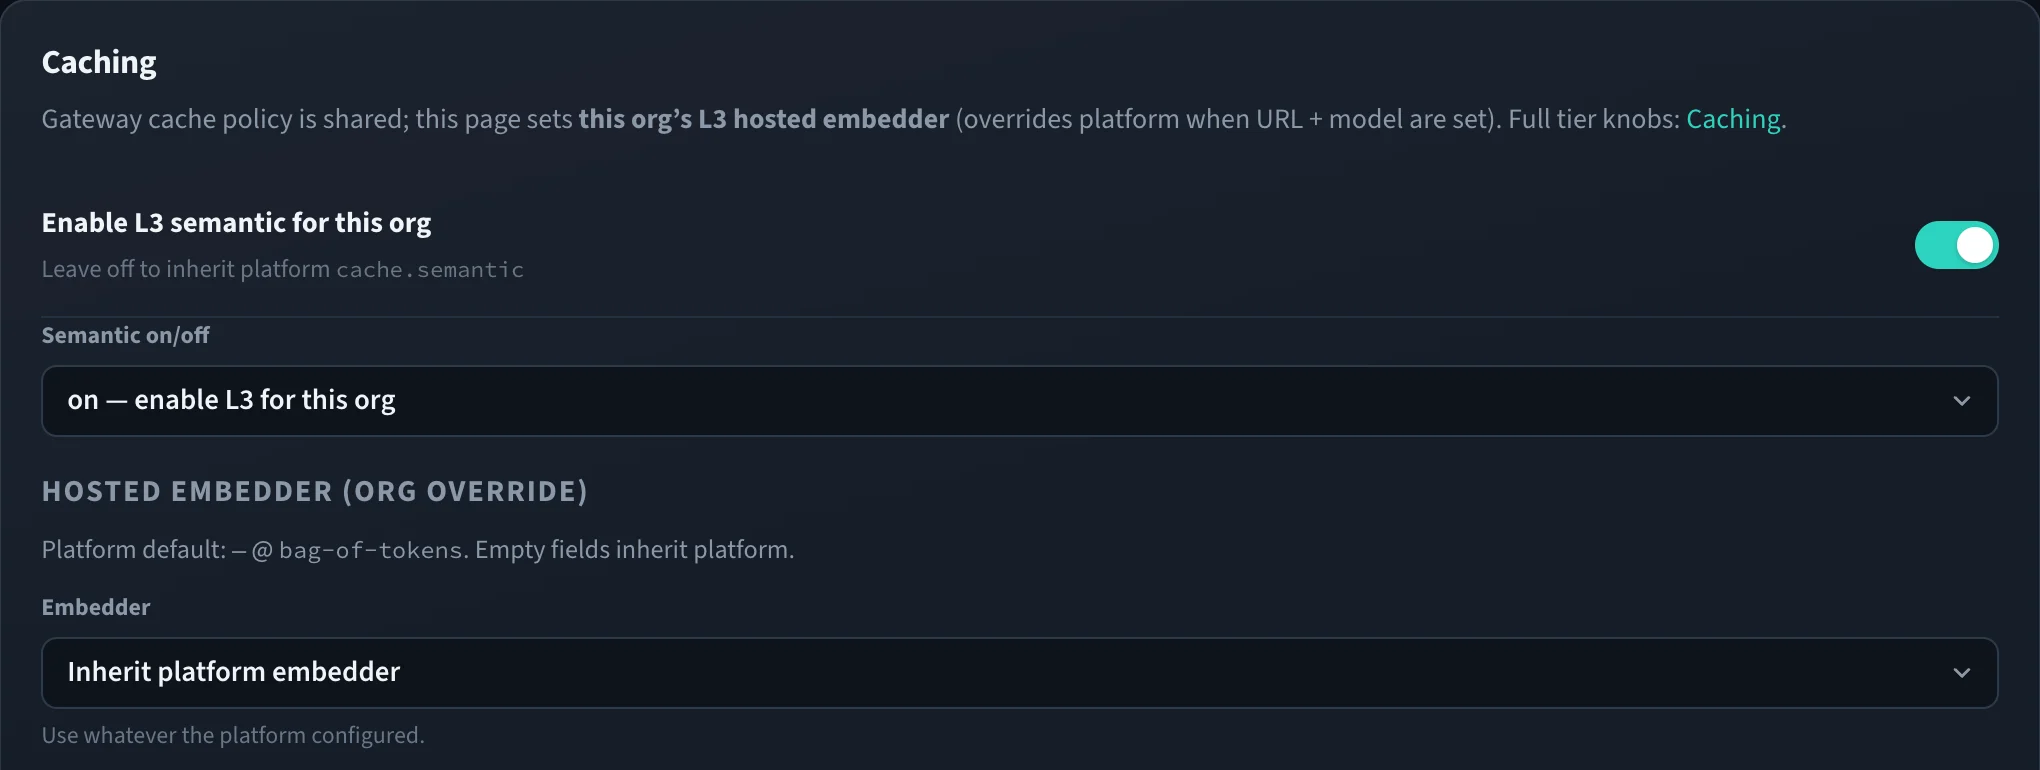
Similarité cosinus sur un embedding sac-de-mots intégré, sans appel externe, ou sur un embedder de votre choix : un point d'accès compatible OpenAI ou un modèle de la passerelle.
Garde-fous anti-faux-positifs
« Capitale de la France » et « capitale de l'Espagne » sont un miss. « Remboursement commande 12345 » et « 12346 » sont un miss. Nombres, négation et entités brisent un hit.
Latence et coût réellement économisés
Un hit contourne entièrement l'appel amont — la réponse porte x-waeg-cache pour voir exactement ce qui a été servi depuis le cache.
Un seul principal par réponse
Une réponse en cache appartient à un utilisateur, une application, une équipe ou une clé, jamais à toute l'organisation. Deux utilisateurs ne partagent jamais une réponse, pas même sur les niveaux approximatifs.
Cache de prompts du fournisseur
L'affinité de session garde une conversation sur un même déploiement, et des indications optionnelles marquent les points d'arrêt du cache Anthropic ou envoient à OpenAI un prompt_cache_key stable.
Éligibilité prudente
Les flux, une température supérieure à zéro et les requêtes avec outils évitent le cache de réponses par défaut. Images, audio, embeddings et OCR n'obtiennent jamais que des hits exacts.
Étape par étape
- 01
Normaliser
La requête est hachée pour une sonde de correspondance exacte, puis canonicalisée — espaces réduits et supprimés aux extrémités, rien qui puisse changer le sens.
- 02
Élargir prudemment
Si l'exact échoue, les niveaux quasi-doublon (SimHash) et sémantique (cosinus) élargissent le filet — chacun plus souple que le précédent, chacun toujours contrôlé.
- 03
Contrôler le sens
Avant de servir un hit quasi-doublon ou sémantique, les garde-fous vérifient que nombres, négation et entités nommées correspondent. Si le sens a changé, c'est un miss.
- 04
Servir ou poursuivre
Un hit contrôlé renvoie immédiatement et est marqué dans les en-têtes de réponse. Un miss poursuit vers le routage et le fournisseur amont.
# Cosmetic noise → HIT (near-dup, gates pass)
"capital of France"  ≈  "capital of France?"
  → near_dup HIT

# Entity changed → gate rejects → MISS
"capital of France"  vs  "capital of Spain"
  → MISS (entity)

# Number changed → gate rejects → MISS
"Refund order 12345"  vs  "Refund order 12346"
→ MISS (number)Cache sémantique est l'une des six surfaces de contrôle appliquées dans le même chemin de requête, valables pour chaque application derrière le point d'entrée — y compris celles qui n'ont jamais été instrumentées.
Voir comment elles se combinentUn point d'entrée. Tous les modèles. Un contrôle total.
Exploitez-le dans votre propre infrastructure
Tout ce qu'il faut pour exploiter une control plane en production est sous Apache-2.0 et le restera — routage, haute disponibilité, cache, bascule, budgets, politique, MCP, tâches et observabilité. Auto-hébergé, sans compte, sans appel vers l'extérieur.
$ docker run -p 4000:4000 <registry>/waeg-gateway:<version>Ce n'est pas un pull qui fonctionne : les images ne sont pas encore publiques. Les partenaires de conception reçoivent les informations du registre en privé.
Déployer en 5 minutesFaçonnez-le en tant que partenaire de conception
Wäg n'est pas encore disponible publiquement. Nous travaillons avec un petit groupe d'équipes qui exploitent de l'IA multi-fournisseurs en production et prennent au sérieux la gouvernance et la souveraineté, afin de durcir la control plane sur des charges réelles.
- Toutes les capacités Enterprise incluses, sans coût de licence
- Migration accompagnée — nous la faisons avec vous, y compris depuis LiteLLM
- Un lien direct avec les ingénieurs et une influence réelle sur la suite