Veloce, ma mai sbagliato
Una cache delle risposte a quattro livelli — esatta, canonica, quasi-duplicato e semantica — con controlli di sicurezza che rifiutano una corrispondenza quando numeri, negazioni o nomi differiscono. Assorbi il rumore; non servire la risposta a un'altra domanda.
"Assorbi il rumore (spazi, virgole, un punto interrogativo di troppo) senza servire risposte sbagliate quando il significato cambia."
L1 · Esatta
Uno SHA-256 sulla richiesta grezza — modello, messaggi, parametri e strumenti. Le chiamate identiche rispondono all'istante, senza alcuna corrispondenza approssimata.
L1b · Canonica
Comprime le sequenze di spazi e rifila le estremità, nient'altro. Niente minuscole né rimozione della punteggiatura, perché possono cambiare il significato.
L2 · Quasi-duplicato
Un SimHash a 64 bit individua le richieste che differiscono solo in modo cosmetico — un punto interrogativo finale, una virgola in più — e ogni candidato deve comunque superare i controlli di sicurezza.
L3 · Semantica
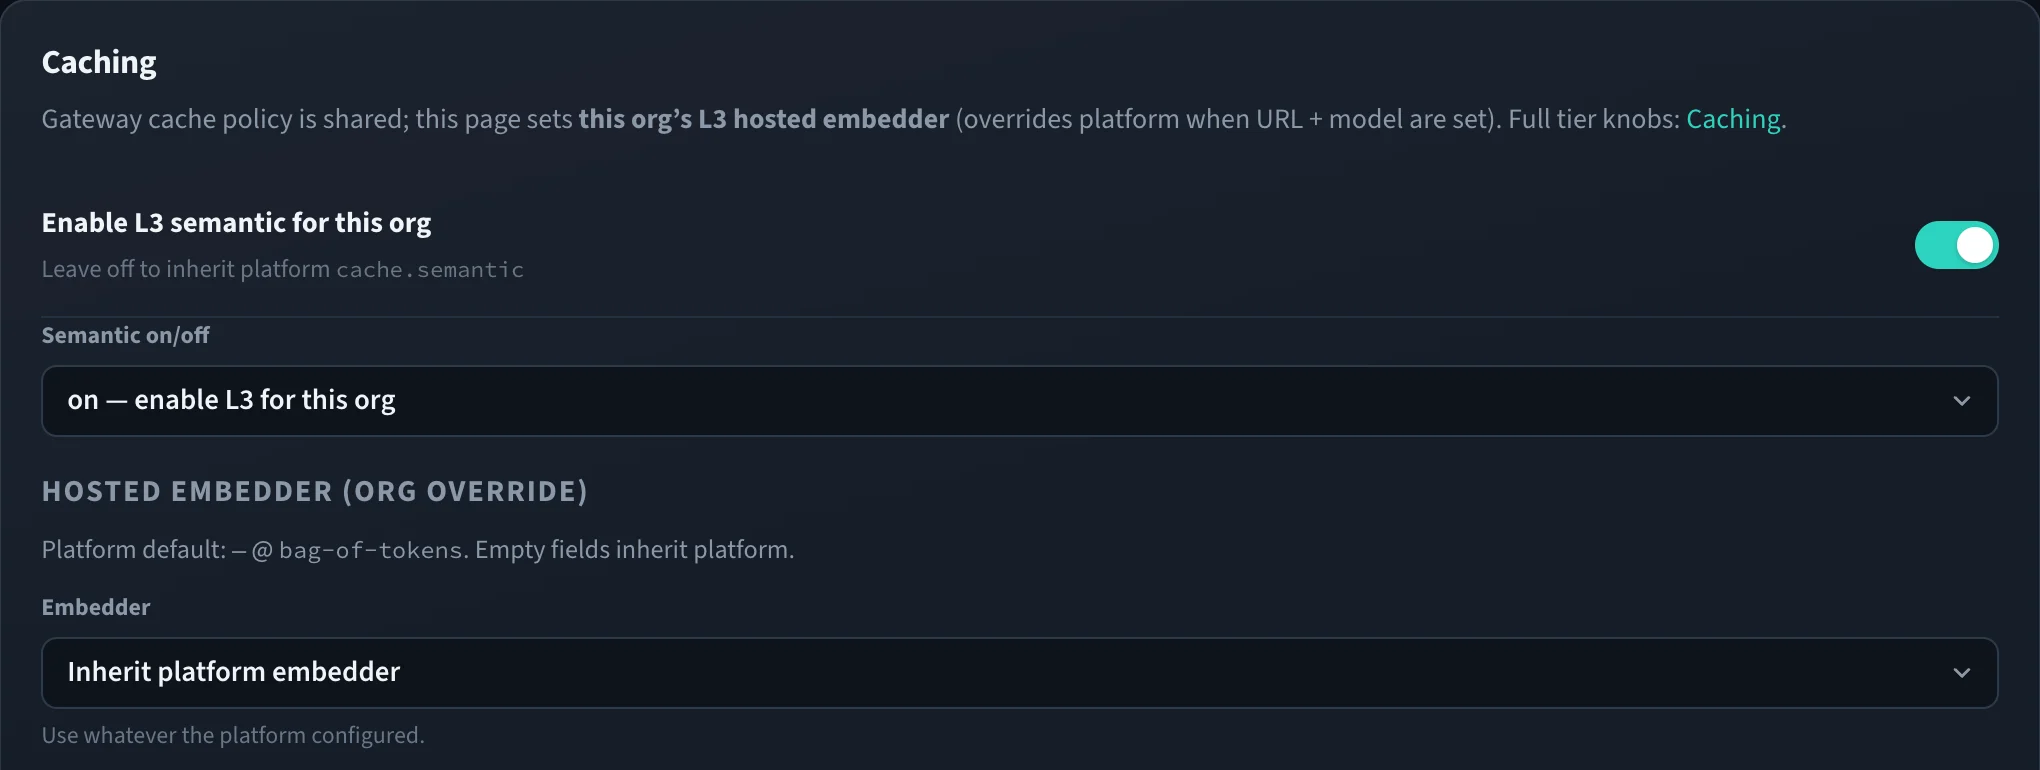
Similarità coseno su un embedding bag-of-words integrato, senza chiamate esterne, o su un embedder a tua scelta: un endpoint compatibile con OpenAI o un modello sul gateway.
Controlli anti-falso-positivo
«Capitale della Francia» e «capitale della Spagna» sono un miss. «Rimborso ordine 12345» e «12346» sono un miss. Numeri, negazione ed entità rompono un hit.
Latenza e costo davvero risparmiati
Un hit salta del tutto la chiamata upstream — la risposta riporta x-waeg-cache così vedi esattamente cosa è stato servito dalla cache.
Un solo principal per risposta
Una risposta in cache appartiene a un utente, un'applicazione, un team o una chiave, mai all'intera organizzazione. Due utenti non condividono mai una risposta, nemmeno sui livelli approssimati.
Prompt caching del provider
L'affinità di sessione mantiene una conversazione su un solo deployment, e suggerimenti opzionali marcano i breakpoint della cache Anthropic o inviano a OpenAI un prompt_cache_key stabile.
Idoneità prudente
Stream, temperatura sopra zero e richieste con strumenti saltano la cache delle risposte per impostazione predefinita. Immagini, audio, embedding e OCR ottengono solo hit esatti.
Passo dopo passo
- 01
Normalizzare
La richiesta viene sottoposta a hash per una verifica di corrispondenza esatta, poi canonicalizzata — spazi compressi e rifilati, nulla che possa cambiare il significato.
- 02
Allargare con cautela
Se l'esatta fallisce, i livelli quasi-duplicato (SimHash) e semantico (coseno) allargano la rete — ciascuno più permissivo del precedente, ciascuno sempre controllato.
- 03
Controllare il significato
Prima di servire un hit quasi-duplicato o semantico, i controlli di sicurezza verificano che numeri, negazioni ed entità nominate corrispondano. Se il significato è cambiato, è un miss.
- 04
Servire o proseguire
Un hit controllato risponde subito ed è marcato negli header di risposta. Un miss prosegue verso il routing e il provider upstream.
# Cosmetic noise → HIT (near-dup, gates pass)
"capital of France"  ≈  "capital of France?"
  → near_dup HIT

# Entity changed → gate rejects → MISS
"capital of France"  vs  "capital of Spain"
  → MISS (entity)

# Number changed → gate rejects → MISS
"Refund order 12345"  vs  "Refund order 12346"
→ MISS (number)Cache semantica è una delle sei superfici di controllo applicate nello stesso percorso della richiesta, valide per ogni applicazione dietro l'endpoint — comprese quelle mai strumentate.
Vedi come si combinanoUn endpoint. Tutti i modelli. Controllo completo.
Gestitelo nella vostra infrastruttura
Tutto ciò che serve per gestire una control plane in produzione è sotto Apache-2.0 e lo resterà — routing, alta disponibilità, cache, failover, budget, policy, MCP, job e osservabilità. Self-hosted, senza account, senza chiamate verso l'esterno.
$ docker run -p 4000:4000 <registry>/waeg-gateway:<version>Non è un pull funzionante: le immagini non sono ancora pubbliche. I partner di progettazione ricevono i dettagli del registry in forma privata.
Avvia in 5 minutiContribuite come design partner
Wäg non è ancora disponibile pubblicamente. Lavoriamo con un piccolo gruppo di team che gestiscono IA multi-provider in produzione e prendono sul serio governance e sovranità, per irrobustire la control plane su carichi reali.
- Tutte le funzioni Enterprise incluse, senza costi di licenza
- Migrazione assistita — la facciamo insieme a voi, anche da LiteLLM
- Una linea diretta con gli ingegneri e un'influenza reale su ciò che arriva dopo