Schnell, aber nie falsch
Ein vierstufiger Antwort-Cache — exakt, kanonisch, Fast-Duplikat und semantisch — mit Sicherheitsschranken, die eine Übereinstimmung ablehnen, wenn sich Zahlen, Verneinung oder Namen unterscheiden. Fangen Sie das Rauschen ab; liefern Sie keine Antwort auf eine andere Frage.
"Rauschen abfangen (Leerzeichen, Kommas, ein überflüssiges Fragezeichen), ohne falsche Antworten auszuliefern, wenn sich die Bedeutung ändert."
L1 · Exakt
Ein SHA-256 über die unveränderte Anfrage — Modell, Nachrichten, Parameter und Tools. Identische Aufrufe antworten sofort, ganz ohne unscharfes Matching.
L1b · Kanonisch
Fasst Folgen von Leerzeichen zusammen und kürzt die Enden, sonst nichts. Keine Kleinschreibung und kein Entfernen von Satzzeichen, weil beides die Bedeutung ändern kann.
L2 · Fast-Duplikat
Ein 64-Bit-SimHash erkennt Anfragen, die sich nur kosmetisch unterscheiden — ein nachgestelltes Fragezeichen, ein zusätzliches Komma —, und jeder Kandidat muss trotzdem die Sicherheitsschranken passieren.
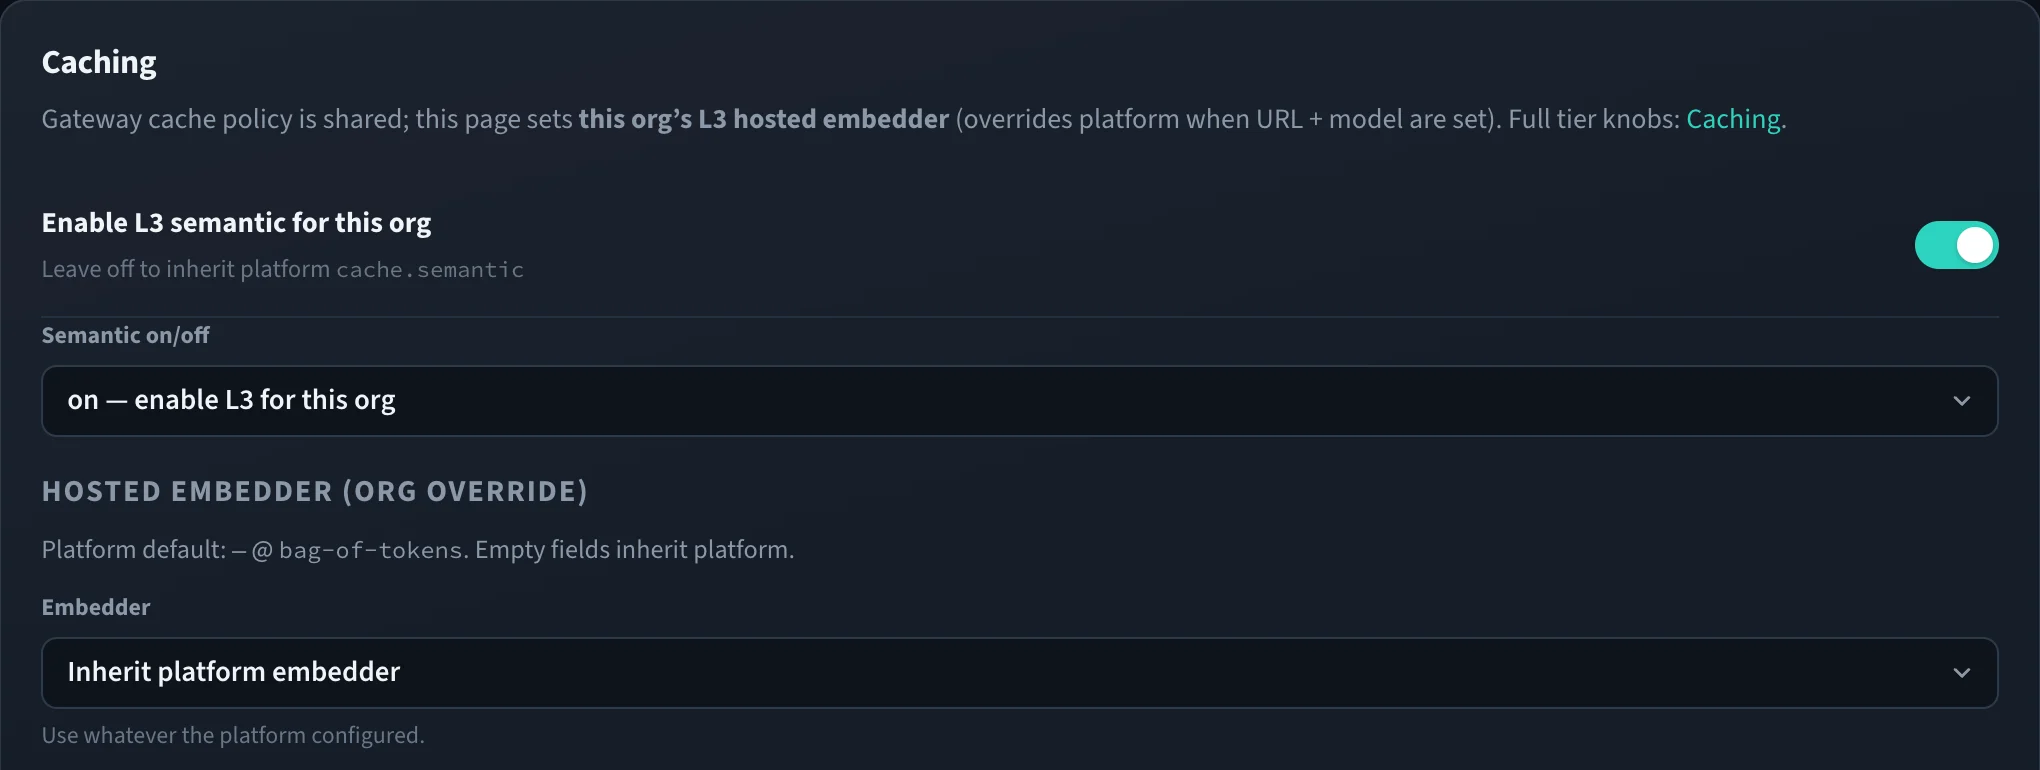
L3 · Semantisch
Kosinus-Ähnlichkeit auf einem eingebauten Bag-of-Words-Embedding ohne externen Aufruf oder auf einem Embedder Ihrer Wahl: einem OpenAI-kompatiblen Endpunkt oder einem Modell am Gateway.
Anti-Falschtreffer-Prüfungen
„Hauptstadt von Frankreich“ und „Hauptstadt von Spanien“ sind ein Miss. „Rückerstattung Bestellung 12345“ und „12346“ sind ein Miss. Zahlen, Verneinung und Entitäten brechen einen Hit.
Echte Latenz & Kosten gespart
Ein Hit umgeht den Upstream-Aufruf vollständig — die Antwort trägt x-waeg-cache, damit Sie genau sehen, was aus dem Cache geliefert wurde.
Ein Principal pro Antwort
Eine gecachte Antwort gehört einem Nutzer, einer Anwendung, einem Team oder einem Key, nie der ganzen Organisation. Zwei Nutzer teilen nie eine Antwort, auch nicht auf den unscharfen Stufen.
Prompt-Caching beim Anbieter
Sitzungsaffinität hält eine Konversation auf einem Deployment, und optionale Hinweise setzen Cache-Breakpoints bei Anthropic oder senden OpenAI einen stabilen prompt_cache_key.
Zurückhaltende Eignung
Streams, Temperatur über null und Anfragen mit Tools umgehen den Antwort-Cache standardmäßig. Bilder, Audio, Embeddings und OCR erhalten nur exakte Treffer.
Schritt für Schritt
- 01
Normalisieren
Die Anfrage wird für eine Exakt-Match-Prüfung gehasht und dann kanonisiert — Leerzeichen zusammengefasst und gekürzt, nichts, was die Bedeutung ändern könnte.
- 02
Vorsichtig erweitern
Wenn exakt fehlschlägt, erweitern die Stufen Fast-Duplikat (SimHash) und semantisch (Kosinus) das Netz — jede lockerer als die vorige, jede weiterhin geprüft.
- 03
Die Bedeutung prüfen
Bevor ein Near-Dup- oder semantischer Treffer ausgeliefert wird, prüfen Sicherheitsschranken, ob Zahlen, Verneinung und benannte Entitäten übereinstimmen. Hat sich die Bedeutung verschoben, ist es ein Miss.
- 04
Ausliefern oder durchreichen
Ein geprüfter Hit antwortet sofort und wird in den Response-Headern markiert. Ein Miss reicht durch zum Routing und zum Upstream-Anbieter.
# Cosmetic noise → HIT (near-dup, gates pass)
"capital of France"  ≈  "capital of France?"
  → near_dup HIT

# Entity changed → gate rejects → MISS
"capital of France"  vs  "capital of Spain"
  → MISS (entity)

# Number changed → gate rejects → MISS
"Refund order 12345"  vs  "Refund order 12346"
→ MISS (number)Semantisches Caching ist eine von sechs Kontrollflächen, die im selben Anfrageweg durchgesetzt werden und für jede Anwendung hinter dem Endpunkt gelten — auch für die, die nie instrumentiert wurden.
Sehen, wie sie zusammenwirkenEin Endpunkt. Jedes Modell. Volle Kontrolle.
Betreiben Sie es in Ihrer eigenen Infrastruktur
Alles, was Sie brauchen, um eine Control Plane produktiv zu betreiben, steht unter Apache-2.0 und bleibt es auch — Routing, HA, Caching, Failover, Budgets, Policy, MCP, Jobs und Observability. Self-hosted, ohne Account, ohne Phone-Home.
$ docker run -p 4000:4000 <registry>/waeg-gateway:<version>Kein funktionierender Pull: Die Images sind noch nicht öffentlich. Designpartner erhalten die Registry-Details vertraulich.
In 5 Minuten deployenAls Design-Partner mitgestalten
Wäg ist noch nicht öffentlich verfügbar. Wir arbeiten mit einer kleinen Gruppe von Teams, die Multi-Provider-KI produktiv betreiben und Governance und Souveränität ernst nehmen, um die Control Plane an echten Workloads zu härten.
- Jede Enterprise-Funktion enthalten, ohne Lizenzkosten
- Migration gemeinsam mit uns — auch von LiteLLM
- Direkter Draht zu den Engineers und realer Einfluss darauf, was als Nächstes kommt