Hurtig, men aldrig forkert
En response-cache i fire niveauer — exact, canonical, near-dup og semantic — med sikkerhedsgates, der afviser et match, når tal, negation eller navne er forskellige. Fang støjen; servér ikke et svar på et andet spørgsmål.
"Fang støj (mellemrum, kommaer, et efterladt spørgsmålstegn) uden at servere forkerte svar, når betydningen ændrer sig."
L1 · Eksakt
En SHA-256 over den rå request — model, beskeder, parametre og tools. Identiske kald returnerer øjeblikkeligt, uden nogen fuzzy matching.
L1b · Canonical
Slår gentagne mellemrum sammen og trimmer enderne, intet andet. Ingen konvertering til små bogstaver eller fjernelse af tegnsætning, for det kan ændre betydningen.
L2 · Næsten-dublet
En 64-bit SimHash fanger requests, der kun adskiller sig kosmetisk — et afsluttende spørgsmålstegn, et ekstra komma — og hver kandidat skal stadig igennem sikkerhedsgates.
L3 · Semantisk
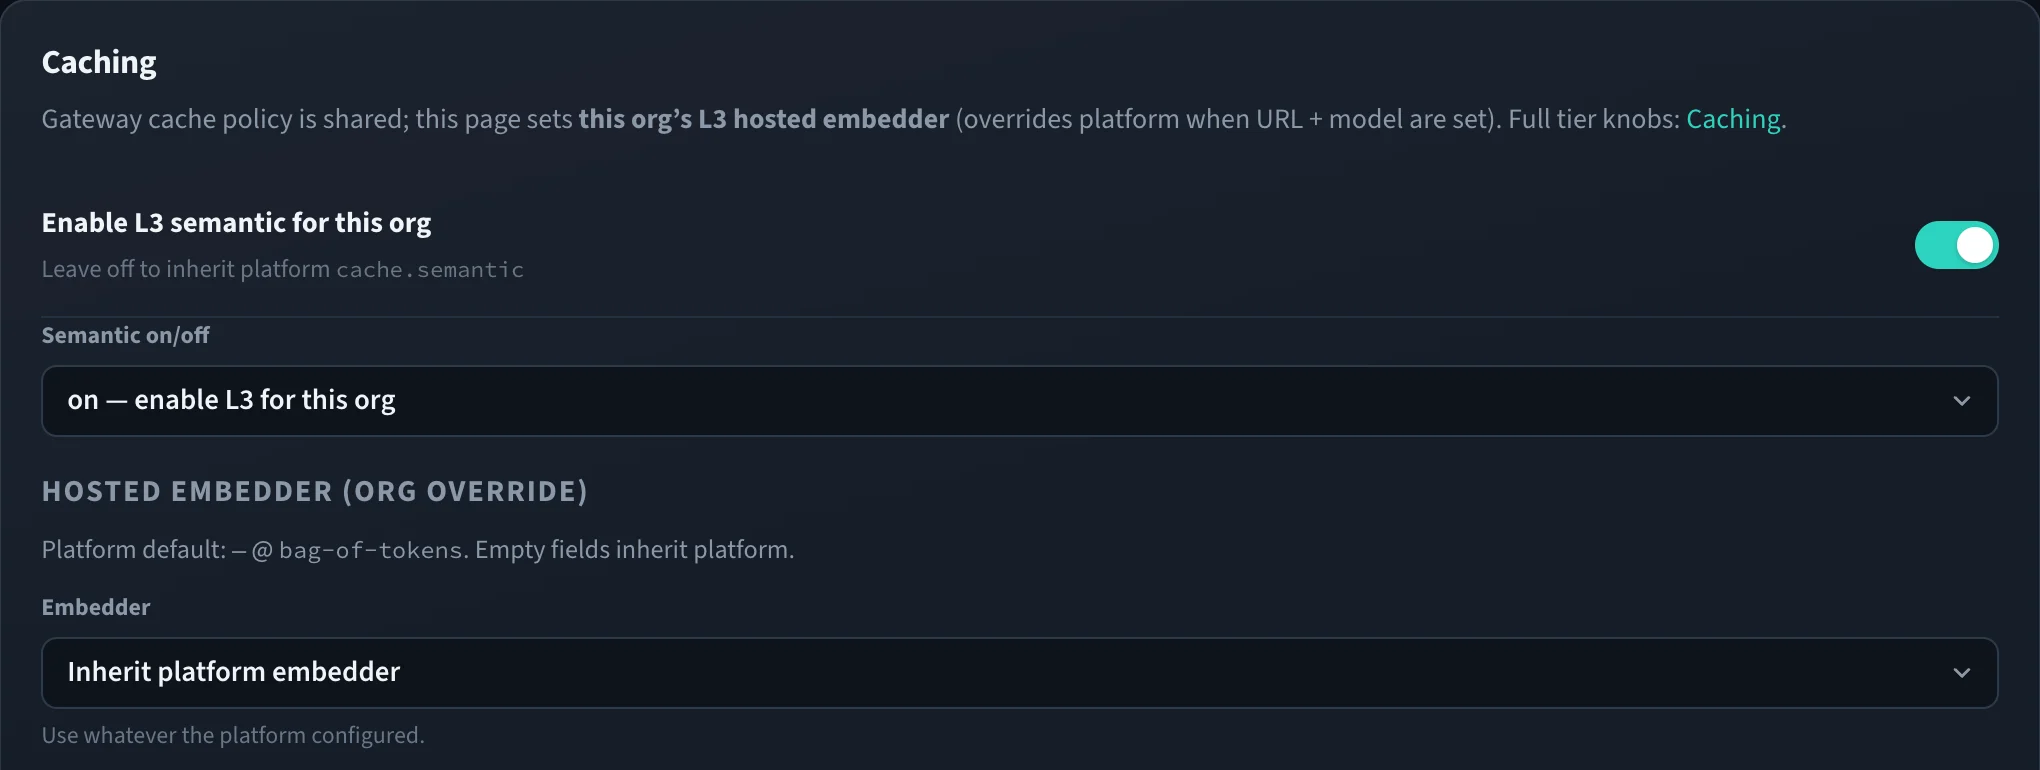
Cosinuslighed på en indbygget bag-of-words-embedding uden eksternt kald, eller på en embedder, du vælger: et OpenAI-kompatibelt endpoint eller en model på gatewayen.
Gates mod falske hits
“Frankrigs hovedstad” og “Spaniens hovedstad” er et miss. “Refundér ordre 12345” og “12346” er et miss. Tal, negation og entiteter bryder et hit.
Reel latens og omkostning sparet
Et hit springer upstream-kaldet helt over — svaret bærer x-waeg-cache, så du kan se præcis, hvad der blev serveret fra cache.
Én principal pr. svar
Et cachet svar tilhører én bruger, applikation, team eller nøgle, aldrig hele organisationen. To brugere deler aldrig et svar, heller ikke på de fuzzy niveauer.
Providerens prompt-caching
Sessionsaffinitet holder en samtale på ét deployment, og valgfri hints markerer Anthropic-cache-breakpoints eller sender OpenAI en stabil prompt_cache_key.
Forsigtig berettigelse
Streams, temperatur over nul og requests med tools springer som standard response-cachen over. Billeder, lyd, embeddings og OCR får kun exact-hits.
Trin for trin
- 01
Normalisér
Requesten hashes til en exact-match-probe og kanoniseres derefter — mellemrum slås sammen og trimmes, intet, der kunne ændre betydningen.
- 02
Udvid forsigtigt
Hvis exact misser, udvider near-dup (SimHash) og semantic (cosinus) nettet — hvert niveau løsere end det forrige, hvert niveau stadig med gates.
- 03
Kontrollér betydningen
Før et near-dup- eller semantisk hit serveres, tjekker sikkerhedsgates, at tal, negation og navngivne entiteter matcher. Har betydningen flyttet sig, er det et miss.
- 04
Servér eller fald igennem
Et godkendt hit returnerer med det samme og markeres i response-headerne. Et miss falder igennem til routing og upstream-provideren.
# Cosmetic noise → HIT (near-dup, gates pass)
"capital of France"  ≈  "capital of France?"
  → near_dup HIT

# Entity changed → gate rejects → MISS
"capital of France"  vs  "capital of Spain"
  → MISS (entity)

# Number changed → gate rejects → MISS
"Refund order 12345"  vs  "Refund order 12346"
→ MISS (number)Semantisk caching er én af seks kontrolflader, der håndhæves i den samme forespørgselsvej og gælder for alle applikationer bag endpointet — også dem, der aldrig blev instrumenteret.
Se hvordan de spiller sammenÉt endpoint. Alle modeller. Fuld kontrol.
Kør det i jeres egen infrastruktur
Alt, hvad I skal bruge for at drive en control plane i produktion, er Apache-2.0 og bliver ved med at være det — routing, HA, caching, failover, budgetter, policy, MCP, jobs og observability. Self-hosted, ingen konto, ingen phone-home.
$ docker run -p 4000:4000 <registry>/waeg-gateway:<version>Endnu ikke et pull, der virker: images er ikke offentlige endnu. Designpartnere får registry-oplysningerne direkte.
Deploy på 5 minutterVær med til at forme det som designpartner
Wäg er endnu ikke offentligt tilgængelig. Vi arbejder sammen med en lille gruppe teams, der kører multi-provider AI i produktion og tager governance og suverænitet alvorligt, for at hærde vores control plane på reelle workloads.
- Alle Enterprise-funktioner inkluderet, uden licensomkostning
- Praktisk migrering — vi gør det sammen med jer, også fra LiteLLM
- Direkte adgang til de engineers, der bygger det, og reel indflydelse på, hvad der kommer næst